E-réputation IA : comment votre marque est-elle présentée par les LLM ?
Auditer votre e-réputation IA consiste à vérifier comment les assistants présentent votre marque, à quels besoins ils la recommandent et si leurs affirmations sont exactes. Être mentionné ne suffit pas. Une réponse flatteuse peut attribuer une offre inexistante ; une remarque critique peut décrire correctement une limite importante pour l’acheteur.
Les LLM (Large Language Models) sont les modèles de langage utilisés par ces assistants. Le GEO (Generative Engine Optimization) désigne ici le travail de visibilité dans leurs réponses.
Pour une PME, l’enjeu n’est donc pas de faire « aimer » sa marque par ChatGPT, Gemini ou Perplexity. Il est de repérer les écarts entre les réponses produites, les informations vérifiables et les attentes des prospects. La méthode proposée ci-dessous distingue six observations, conserve les conditions des tests et débouche sur des corrections concrètes. Elle ne prétend pas mesurer toutes les conversations des utilisateurs.
Ce qu’il faut retenir
- Une mention, une citation et une recommandation sont trois événements différents.
- La tonalité décrit le texte produit, pas un sentiment conscient du modèle.
- L’exactitude et l’adaptation au besoin doivent être vérifiées séparément.
- Un audit repose sur un échantillon documenté, des répétitions et des dénominateurs explicites.
- Les corrections portent d’abord sur les informations et les problèmes réels, sans faux avis ni promesse de recommandation.
Que mesure réellement l’e-réputation IA ?
L’e-réputation IA désigne ici la manière dont une marque est décrite et évaluée dans les réponses générées. Cette définition opérationnelle complète la mesure de visibilité : apparaître ne signifie pas être présenté correctement, ni être pertinent pour le besoin exprimé.
L’expression « Sentiment Engine Optimization », proposée dans la chronique de Zacharia Alhyan publiée au Journal du Net le 10 novembre 2026, peut attirer l’attention sur cette dimension qualitative. Elle n’est toutefois pas une nomenclature officielle des assistants, ni un remplacement du SEO. Dans cet article, « sentiment de marque dans les IA » signifie uniquement le codage de la tonalité d’un texte. Nous ne prêtons aucune émotion consciente aux modèles.
La vérification reste indispensable : OpenAI reconnaît que ChatGPT peut produire des informations erronées ou trompeuses, y compris des références fabriquées. Une citation n’est donc pas un certificat de vérité. Il faut ouvrir la source et contrôler qu’elle soutient effectivement l’affirmation.
Pour approfondir la distinction entre présence et réputation, notre article sur les mentions de marque et la visibilité GEO fournit un cadre complémentaire.
Comment lire une réponse selon 6 dimensions ?
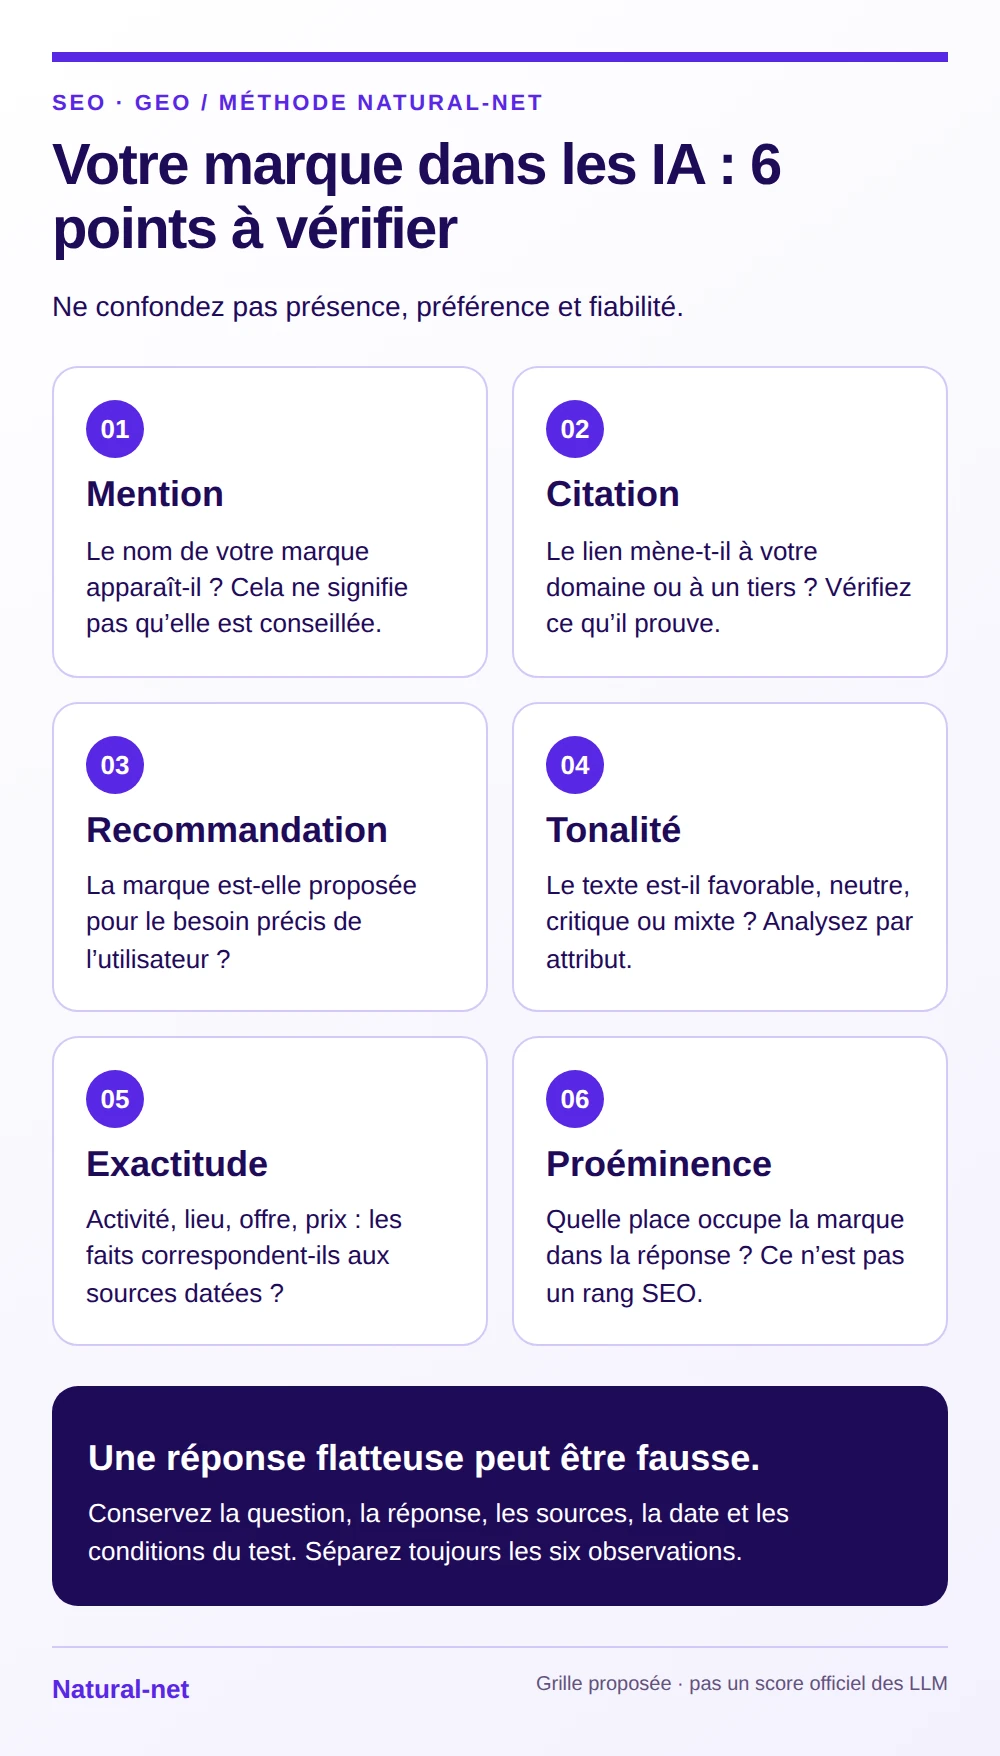
Adoptez une grille stable avant de lancer les tests. Les six dimensions ci-dessous constituent une proposition méthodologique, pas un indicateur officiel de ChatGPT, Gemini ou Perplexity.
Sur mobile, faites défiler le tableau horizontalement pour lire toutes les colonnes.
| Dimension | Observation à consigner | Confusion à éviter |
|---|---|---|
| Mention | Nom de marque identifiable dans la réponse | Compter chaque occurrence comme une recommandation |
| Citation | Lien vers le domaine cible et/ou source tierce, séparément | Attribuer à votre site une citation d’un comparateur |
| Recommandation | Proposition explicite de choisir ou contacter la marque, adaptée au besoin | Assimiler une liste descriptive à un conseil d’achat |
| Tonalité par attribut | Favorable, défavorable, neutre ou mixte sur le prix, le service, l’offre… | Résumer une réponse nuancée par « positif » |
| Exactitude | Faits justes, faux ou non vérifiables après contrôle | Déduire la vérité du ton assuré |
| Proéminence | Place qualitative : réponse centrale, liste, détail secondaire | Présenter cet ordre comme une position SEO |
Pourquoi coder la tonalité par attribut ?
Exemple fictif, uniquement illustratif : un assistant décrit une marque comme « haut de gamme, avec un prix élevé ». Pour une personne cherchant le moins cher, cela signale une inadéquation possible. Pour une personne privilégiant une finition particulière, le même positionnement peut être pertinent. Le prix élevé n’est pas automatiquement une appréciation négative.
Conservez la formulation exacte et l’attribut concerné. Une réponse peut être favorable sur la qualité et critique sur les délais : le statut « mixte » évite de perdre cette information.
Comment construire un audit d’e-réputation dans les IA reproductible ?
La solidité d’un audit vient davantage de son protocole que du nombre de captures. Définissez ce que vous voulez observer, puis gardez un échantillon comparable dans le temps.
Séparer trois familles de questions
Les prompts neutres demandent une description de l’activité ou des offres. Les prompts comparatifs précisent un besoin, une zone et des critères de choix. Les prompts critiques interrogent les limites, les avis ou les points de vigilance.
Voici trois formulations illustratives à adapter à vos offres et aux questions reçues :
- Description neutre : « Que propose [marque] dans [zone] ? »
- Choix comparatif : « Quelles solutions conviennent à [besoin, zone et contraintes] ? »
- Vigilance critique : « Quels points vérifier avant de choisir [marque] ? »
Analysez ces familles séparément. Une question demandant explicitement des défauts ne peut pas être comparée directement à une question descriptive. Évitez également les formulations orientées, telles que « pourquoi cette marque est-elle la meilleure ? ».
Ces prompts sont des scénarios créés pour l’audit, pas des conversations privées récupérées auprès des assistants. Un même scénario peut être testé avec et sans nom de marque ; conservez ces deux catégories distinctes.
Fixer les conditions et répéter
Pour chaque réponse, archivez le prompt exact, la langue, le pays du test, le produit, le modèle s’il est identifiable, la date, le mode et l’activation éventuelle de la recherche web. Démarrez une conversation neuve et conservez la réponse complète, ses liens et les éventuels échecs techniques.
Prévoyez plusieurs répétitions selon une règle fixée à l’avance. Ne relancez pas uniquement les réponses défavorables jusqu’à obtenir un résultat souhaité. Comparez des configurations équivalentes ; un changement de modèle ou de mode doit être signalé, pas interprété automatiquement comme une évolution de réputation.
Définir les dénominateurs avant le calcul
Utilisez la réponse comme unité pour la présence et les citations, mais l’affirmation factuelle pour l’exactitude. Affichez les effectifs à côté des taux ; un petit échantillon ne décrit pas le marché.
Sur mobile, faites défiler le tableau horizontalement pour lire toutes les colonnes.
| Indicateur proposé | Calcul ou définition | Dénominateur à afficher |
|---|---|---|
| Taux de mention | Réponses mentionnant la marque / réponses valides analysées | Réponses, par famille et configuration |
| Taux de citation du domaine | Réponses avec au moins un lien vers le domaine cible / réponses analysables en mode recherche web | Réponses en mode recherche web, par configuration ; les sources tierces sont présentées séparément |
| Taux de recommandation adaptée | Réponses conseillant explicitement la marque pour le besoin / réponses valides aux questions de choix | Réponses des seuls scénarios de sélection |
| Répartition de tonalité | Nombre de qualifications favorables, défavorables, neutres ou mixtes, par attribut | Qualifications codées pour cet attribut |
| Exactitude des faits contrôlés | Faits justes / faits vérifiés comme justes ou faux | Affirmations contrôlées ; non vérifiables à part |
| Couverture de vérification | Affirmations contrôlées comme justes ou fausses / affirmations factuelles relevées | Toutes les affirmations factuelles relevées |
| Proéminence | Réponse centrale, liste ou mention secondaire | Réponses mentionnant la marque |
Une absence de marque est un résultat valide, pas un échec technique. Si un assistant ne répond pas, consignez cet échec séparément. Avec des répétitions inégales, les prompts les plus relancés pèseraient davantage : standardisez les répétitions ou présentez une moyenne par prompt clairement identifiée.
Enfin, faites relire les formulations ambiguës par une seconde personne. Pour un outil de suivi, le pilotage des réponses IA avec Qwairy doit rester associé à cette vérification qualitative.
Pourquoi croiser exactitude et recommandation ?
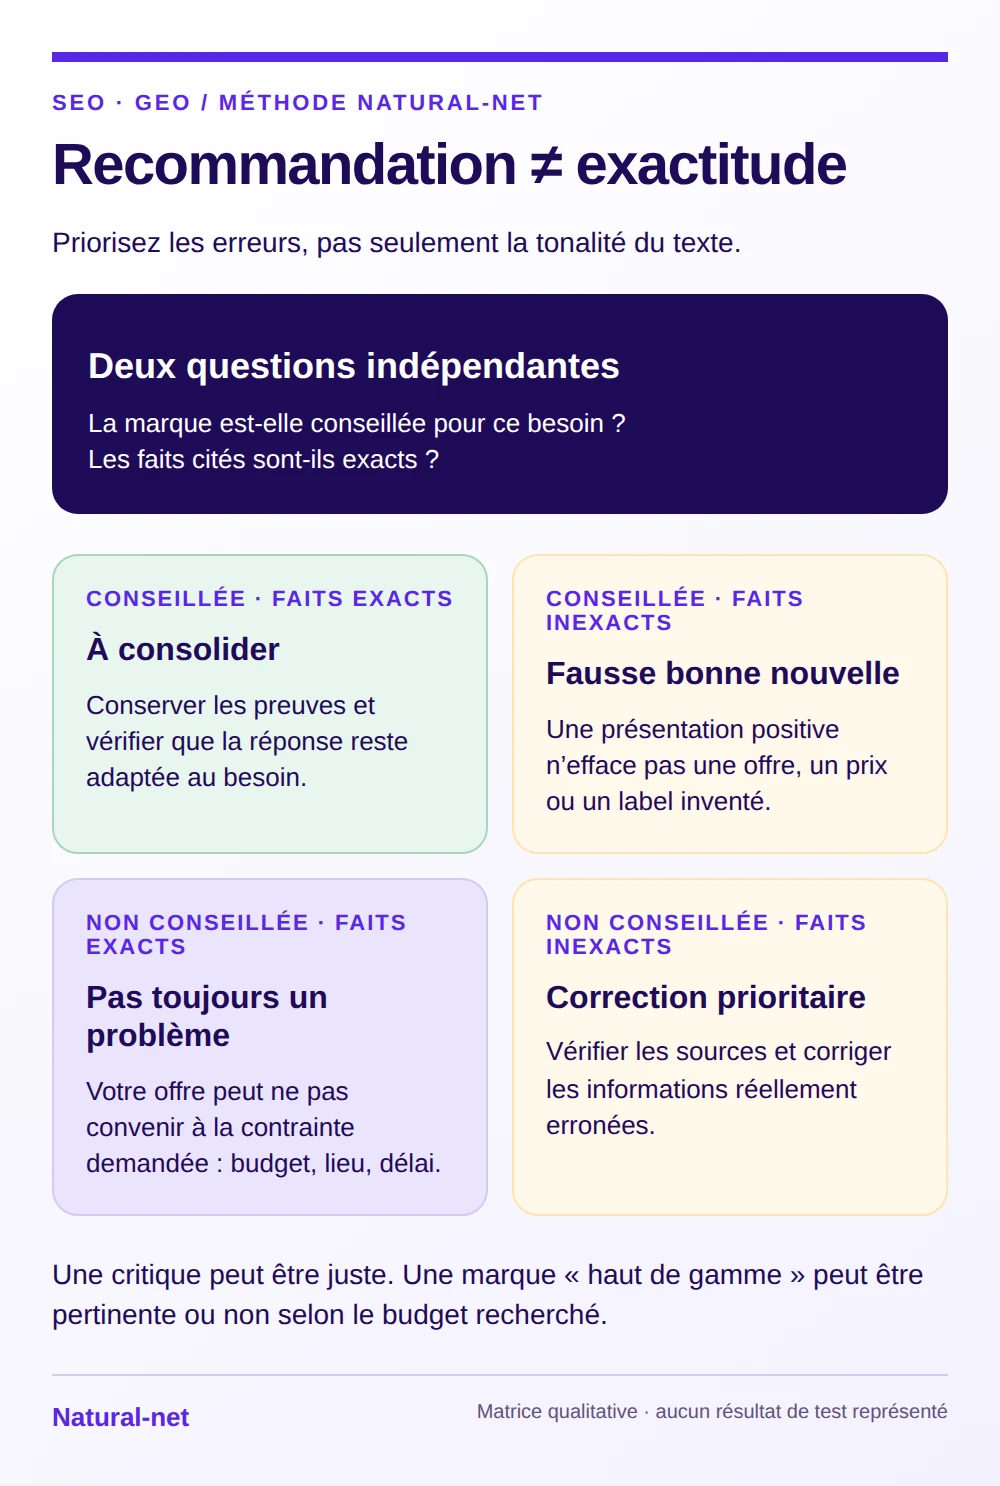
Une marque recommandée pour la mauvaise raison mérite une correction, pas une célébration. Croiser ces deux axes aide à prioriser les écarts sans fabriquer un « score de réputation » universel.
Sur mobile, faites défiler le tableau horizontalement pour lire toutes les colonnes.
| Recommandation explicite observée | Recommandation non observée | |
|---|---|---|
| Informations vérifiées exactes | Vérifier aussi l’adéquation au besoin ; consolider les preuves | Vérifier l’adéquation de l’offre ; l’absence peut être légitime |
| Informations inexactes | Corriger les faits, même si la réponse est favorable | Corriger les faits avant d’interpréter le positionnement |
La matrice sépare la présence d’un conseil et l’exactitude des faits. L’adéquation du conseil au besoin fait l’objet d’un contrôle supplémentaire. Les faits non vérifiables restent hors de cette matrice, avec un statut explicite. L’absence de recommandation n’est pas, à elle seule, un jugement négatif.
Exemple fictif : une entreprise locale est conseillée pour une intervention nationale qu’elle ne propose pas. Le problème est l’exactitude et l’adéquation de l’offre, même si le ton est enthousiaste.
Comment corriger les causes plutôt que les adjectifs ?
Rendre les informations vérifiables
Priorisez les erreurs pouvant tromper un prospect : activité, localisation, périmètre, prix, disponibilité, qualifications. Identifiez une source de référence, son responsable et sa date de validité. Corrigez ensuite les pages et profils que vous contrôlez ; pour une information tierce erronée, demandez une rectification avec des preuves.
La documentation OpenAI sur ses robots distingue OAI-SearchBot, destiné aux fonctions de recherche, de GPTBot, lié à l’entraînement. Autoriser l’exploration de recherche peut contribuer à l’accès aux contenus, mais ne garantit ni citation ni recommandation. Les réglages sont indépendants et ne constituent pas une règle commune à tous les assistants.
Traiter les problèmes réels
Une critique factuellement juste appelle une réponse opérationnelle : clarification des conditions, amélioration du service ou résolution d’une difficulté client. Chercher à supprimer toute critique ferait perdre un signal utile.
Ne fabriquez pas d’avis et n’utilisez pas le balisage comme une promesse de réputation IA. Google encadre les avis structurés : avis visibles sur la page, absence d’avis fictifs ou d’incitations non divulguées. Les avis auto-promotionnels contrôlés par une entité LocalBusiness ou Organization ne sont pas éligibles aux étoiles d’avis correspondantes, même avec un widget tiers. Ce cadre ne prouve aucun effet sur la tonalité des assistants.
Après correction, rejouez le même protocole et documentez les écarts. Une réponse différente ne suffit pas à établir que votre modification en est la cause.
FAQ : 5 questions sur l’e-réputation IA
Une mention de marque dans ChatGPT est-elle une recommandation ?
Non. La marque peut être citée comme exemple, concurrent ou objet d’une critique. Recherchez une proposition explicite de choix, puis vérifiez son adéquation au besoin.
Une source citée rend-elle une réponse fiable ?
Non. Contrôlez l’existence du lien, sa date et le passage probant. OpenAI mentionne notamment le risque de références fabriquées.
Peut-on attribuer un score de sentiment unique à une marque ?
Un score peut résumer un codage interne, mais masque les attributs et les conditions. Préférez une répartition contextualisée, avec les réponses mixtes, les effectifs et les règles de codage.
Search Console mesure-t-elle la réputation dans les assistants ?
Non. Le rapport IA documenté par Google mesure des impressions de liens dans AI Overviews et AI Mode de Google Search. Il ne mesure pas les mentions sans lien ni la réputation dans les applications ChatGPT, Gemini ou Perplexity.
Les avis positifs garantissent-ils une meilleure recommandation IA ?
Aucune garantie de ce type n’est établie par les sources retenues. Travaillez la qualité réelle du service, des avis authentiques et des informations cohérentes, sans promettre de causalité mécanique.
Passer à un diagnostic exploitable
Une e-réputation IA utile se lit sur deux axes prioritaires : la justesse de la présentation et sa pertinence pour le besoin. Les mentions et la tonalité apportent du contexte, pas un verdict automatique.
Le travail sur les sources et les informations de l’entreprise rejoint aussi notre guide sur la coordination SEO, SEA et GEO dans la recherche multimodale.
Pour cadrer un échantillon, distinguer les erreurs des appréciations et prioriser les corrections, vous pouvez échanger avec Natural-net sur un audit de visibilité IA et GEO. L’objectif est un diagnostic vérifiable, non une promesse de préférence des assistants.
Sources et références
- OpenAI — Overview of OpenAI Crawlers.
- OpenAI — Does ChatGPT tell the truth?.
- Google Search Central — Review snippet structured data, mise à jour affichée : 8 septembre 2026.
- Google Search Console — Generative AI performance report, Search, note de déploiement : 31 août 2026.