Jev de TypeSafe : une IA qui décide au lieu de rédiger ?
Jev est un modèle d’intelligence artificielle développé par TypeSafe pour produire des décisions structurées plutôt que du texte libre.
Au lieu de rédiger une réponse comme un assistant conversationnel, il choisit parmi des options, attribue des scores et renvoie des probabilités. TypeSafe le présente comme son premier « System One Model » : une IA pensée pour être appelée par des logiciels, et non uniquement pour dialoguer avec des humains.
Cette différence peut sembler discrète. Elle touche pourtant à une question centrale de l’évolution de l’IA : faut-il demander à un modèle de générer des phrases chaque fois qu’un programme a seulement besoin de choisir une catégorie, d’évaluer une proposition ou de sélectionner une action ?
Avec Jev, TypeSafe propose une autre interface entre l’intelligence artificielle et le code. Pour comprendre ce qui change réellement, il faut distinguer le concept, les fonctions déjà documentées et les promesses encore à éprouver.
Voici un guide du fonctionnement de Jev, de ses usages, de son accès par API, de son prix et de ses limites.
Sommaire
Ce qu’il faut retenir
- Jev est une IA de décisions, pas un chatbot. Développé par TypeSafe, il renvoie des choix, des scores et des probabilités plutôt que des réponses rédigées.
- Le concept « System One Model » vise une IA directement utilisable par le logiciel. Le modèle interprète un contexte ; le programme encadre l’utilisation de sa réponse.
- Trois types de questions structurent son fonctionnement : Choice pour choisir une option, Score pour évaluer selon une échelle et Noul pour estimer la probabilité d’un « oui ».
- Jev peut compléter les LLM, sans les remplacer pour tout. Il n’est pas conçu pour rédiger un article, produire du code ou expliquer librement un raisonnement.
- Un format correct ne garantit pas une décision juste. Les sorties contraintes et les indicateurs de confiance n’éliminent pas les erreurs de compréhension ou de choix.
- Les performances restent à replacer dans leur contexte. La plage de 70 à 500 ms et les gains de coût publiés proviennent des évaluations de TypeSafe, pas d’une garantie universelle.
L’idée centrale : toutes les tâches d’IA ne nécessitent pas de générer du texte. Jev propose de séparer plus nettement la génération, la décision et l’action.
Qu’est-ce que Jev de TypeSafe ?
Jev est un modèle de décisions structurées. Une application lui transmet un contexte et des questions dont les réponses possibles sont encadrées. Le modèle retourne des valeurs que le programme peut exploiter : une option sélectionnée, un score ou une probabilité de réponse positive.
Un exemple simple permet de comprendre la différence. À la question « Quel est le sujet de ce texte ? », un assistant peut répondre par un paragraphe explicatif. Avec Jev, l’application peut définir les catégories « science », « technologie », « culture » et « autre ». Elle récupère ensuite un choix et les probabilités associées aux options, sans demander la rédaction d’une explication.
Un LLM, pour Large Language Model ou grand modèle de langage, est notamment capable de générer du langage. Jev met l’accent sur une autre tâche : fournir une décision à un logiciel. Il ne faut donc pas confondre la compréhension d’une instruction formulée en langage naturel avec la production d’une réponse rédigée.
Jev ne rédige pas d’articles, ne produit pas de code et ne génère pas d’explication libre de son raisonnement. Cette restriction n’est pas un manque accidentel de son interface : elle est au cœur du positionnement de TypeSafe. L’éditeur cherche à rendre certaines décisions plus rapides et directement utilisables dans des logiciels.
| Élément | À retenir |
|---|---|
| Éditeur | TypeSafe AI |
| Annonce publique | 15 septembre 2026 |
| Catégorie proposée par l’éditeur | System One Model |
| Fonctions principales | Choisir, classer, scorer et évaluer des questions définies |
| Sorties | Valeurs typées, probabilités et indicateurs de confiance selon la question |
| Accès documenté | Playground, API et SDK ; accès anticipé au lancement |
| Génération de texte libre | Non |
| Point de vigilance essentiel | Une réponse au bon format peut rester incorrecte |
Ce positionnement évite un contresens fréquent : Jev n’est pas simplement un ChatGPT plus rapide. Il abandonne une partie de la liberté de génération pour se concentrer sur une autre façon d’utiliser un modèle.
Qui est derrière TypeSafe et pourquoi le modèle s’appelle-t-il Jev ?
Diogo Almeida, Erik Gafni et Sasha Sheng
TypeSafe AI est un laboratoire d’IA fondé en 2024 et basé à San Francisco. Ses trois cofondateurs sont Diogo Almeida, Erik Gafni et Sasha Sheng. Almeida, dirigeant de TypeSafe, est un ancien chercheur d’OpenAI qui a participé aux travaux sur le suivi d’instructions à l’origine des assistants conversationnels modernes.
Dans son annonce, il part d’un constat : les progrès des modèles capables de discuter ne suffisent pas nécessairement à rendre l’IA facile à intégrer dans des programmes fiables. Une réponse très convaincante pour un lecteur peut rester difficile à exploiter lorsqu’un logiciel attend une valeur précise, dans un délai court et selon un contrat de sortie stable.
La proposition de TypeSafe consiste donc à développer une intelligence « native pour les machines ». Cette expression décrit ici une interface conçue pour le logiciel : des questions explicites en entrée, des résultats structurés en sortie et une gestion de l’incertitude utilisable dans le code.
Jev fait référence au paradoxe de Jevons
TypeSafe indique avoir nommé Jev en référence à William Stanley Jevons. Le raisonnement évoqué par l’éditeur est le suivant : lorsqu’une ressource devient beaucoup plus efficace à utiliser, ses usages peuvent se multiplier au lieu de simplement diminuer la consommation totale.
Appliquée à l’IA, cette idée signifie qu’une décision moins coûteuse pourrait être insérée à davantage d’endroits dans un logiciel. Un modèle rapide ne servirait pas seulement à accélérer des tâches déjà connues ; il pourrait rendre envisageables des traitements trop coûteux ou trop lents auparavant.
Il s’agit d’une hypothèse sur l’évolution des usages, pas d’une preuve que Jev réduira la consommation globale de calcul ou d’énergie. Un coût plus faible par appel et un coût total plus faible ne sont pas la même chose si le nombre d’appels augmente fortement.
Qu’est-ce qu’un « System One Model » ?
Une référence à la pensée rapide, pas un cerveau artificiel démontré
Le nom « System One » s’inspire de la distinction popularisée par Daniel Kahneman dans Thinking, Fast and Slow, entre une pensée rapide et intuitive et une pensée plus lente et délibérée. TypeSafe reprend cette référence pour mettre en avant des décisions rapides, par opposition à la production de longues réponses.
L’analogie doit rester limitée. Elle ne prouve pas que Jev reproduit une architecture cognitive humaine. Elle ne signifie pas non plus que tous les LLM correspondent strictement à un « système 2 ». System One Model est le nom donné par TypeSafe à une orientation de produit et de recherche, et non une catégorie scientifique dont toutes les propriétés seraient déjà établies.
Passer d’une réponse à lire à une valeur à utiliser
Un programme traditionnel applique des règles explicites : si une condition est remplie, il exécute une action. Ces règles sont très efficaces lorsque les données sont bien définies. Elles deviennent plus difficiles à écrire lorsqu’il faut interpréter un texte ambigu, reconnaître une intention ou apprécier la pertinence d’un document.
Un System One Model vise cette zone intermédiaire. Il fournit une appréciation probabiliste là où une règle écrite à la main serait trop rigide. Le reste du programme conserve les contraintes : les options autorisées, les seuils, les permissions et les conditions de recours à une personne.
On peut résumer l’idée ainsi : le modèle interprète une situation ; le code détermine comment utiliser son résultat. Il ne s’agit pas de remplacer tout le logiciel par de l’IA, mais de rendre certaines étapes sensibles au sens des informations reçues.
Un modèle n’est ni un agent complet ni une application grand public
Trois niveaux sont souvent confondus. Le modèle réalise une prédiction ou une génération. L’agent organise des étapes, utilise éventuellement des outils et observe les résultats. L’application fournit une interface et un service à l’utilisateur.
Jev se situe d’abord au niveau du modèle et de son API. Il peut devenir un composant d’un agent, mais ne constitue pas à lui seul un système complet de navigation, de recherche ou d’exécution autonome. Notre guide sur la définition et le fonctionnement des agents IA permet d’approfondir cette distinction.
Cette différence explique aussi pourquoi Jev ne s’utilise pas comme un outil de création à partir de documents. Notre guide NotebookLM consacré aux infographies, podcasts et vidéos décrit un autre niveau d’usage : une application pensée pour produire des contenus. Jev, lui, fournit des décisions à une application qui en organisera ensuite l’exploitation.
Comment fonctionne Jev ?
Un état, des questions et des réponses encadrées
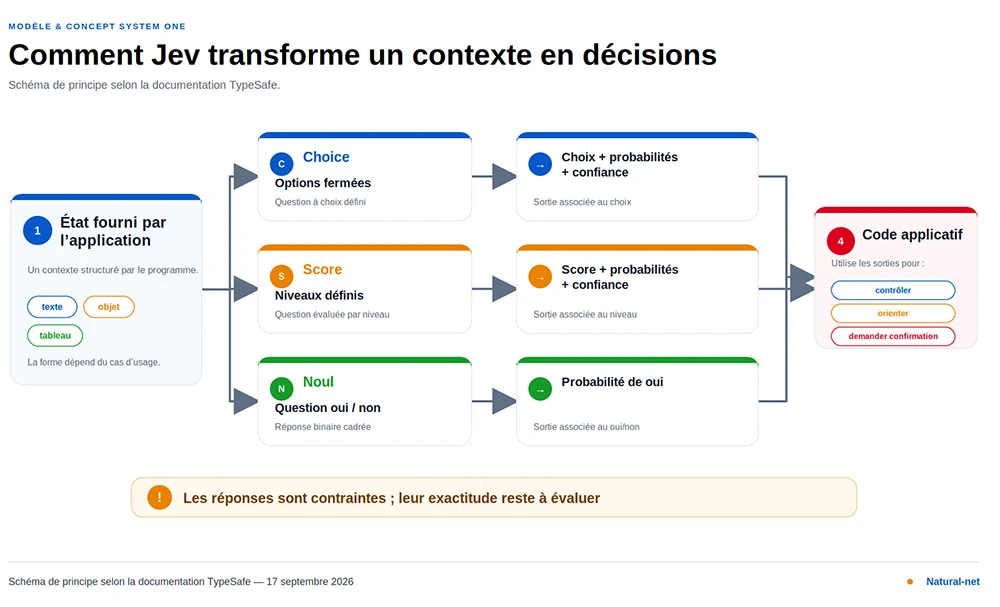
Dans la documentation TypeSafe, le contexte transmis au modèle s’appelle le state, c’est-à-dire l’état. Il peut s’agir d’un texte, d’un objet ou d’un tableau. Ce contexte décrit la situation à évaluer : un document, un message, une étape de traitement ou encore l’état d’un jeu.
L’application ajoute des questions. Chacune précise le résultat attendu et les critères applicables. Le modèle n’a donc pas seulement pour consigne de « répondre correctement » : il travaille à l’intérieur d’un espace de réponses défini.
Un schéma fixe la structure de ces réponses. Un type indique leur nature. Cette discipline permet au programme de savoir ce qu’il recevra, tout en laissant au modèle la tâche d’interpréter le contexte.
Choice : choisir parmi des options
La primitive Choice sert à sélectionner une option dans une liste. L’application fournit des catégories ou des possibilités, avec leur description. Jev retourne le choix retenu, la distribution des probabilités sur les options et un indicateur de confiance.
Par exemple, un texte peut être classé comme « tutoriel », « actualité », « analyse » ou « autre ». La catégorie « autre » est importante : sans option adaptée, une liste fermée peut forcer une réponse peu pertinente. Le bon fonctionnement dépend donc aussi de la manière dont la question est construite.
Score : évaluer selon une échelle définie
La primitive Score permet d’évaluer un élément sur des niveaux ordonnés. Ces niveaux doivent avoir un sens explicite : une information peut être absente, partielle ou complète ; une proposition peut correspondre faiblement ou fortement à un critère.
La documentation décrit un score calculé à partir des probabilités des niveaux. Il peut donc se situer entre deux niveaux de l’échelle. Ce n’est pas nécessairement la simple sélection d’une note entière. L’échelle et sa signification restent définies par l’application.
Noul : estimer la probabilité d’un « oui »
La primitive Noul répond à une question binaire par une probabilité comprise entre 0 et 1. Par exemple : « Ce texte contient-il une procédure ? » ou « Cette proposition nécessite-t-elle une clarification ? »
Une réponse Noul n’inclut pas de champ confidence distinct. Sa valeur représente la probabilité de la réponse positive. Le programme doit ensuite décider comment utiliser cette probabilité ; elle ne constitue pas une instruction d’agir automatiquement.
| Primitive | Question adaptée | Sortie documentée |
|---|---|---|
| Choice | Quelle option correspond au contexte ? | Choix, probabilités et confiance |
| Score | À quel niveau correspond le contexte ? | Score, niveaux, probabilités et confiance |
| Noul | La proposition est-elle vraie ? | Probabilité d’une réponse positive |
Des sorties en parallèle plutôt qu’une génération token par token
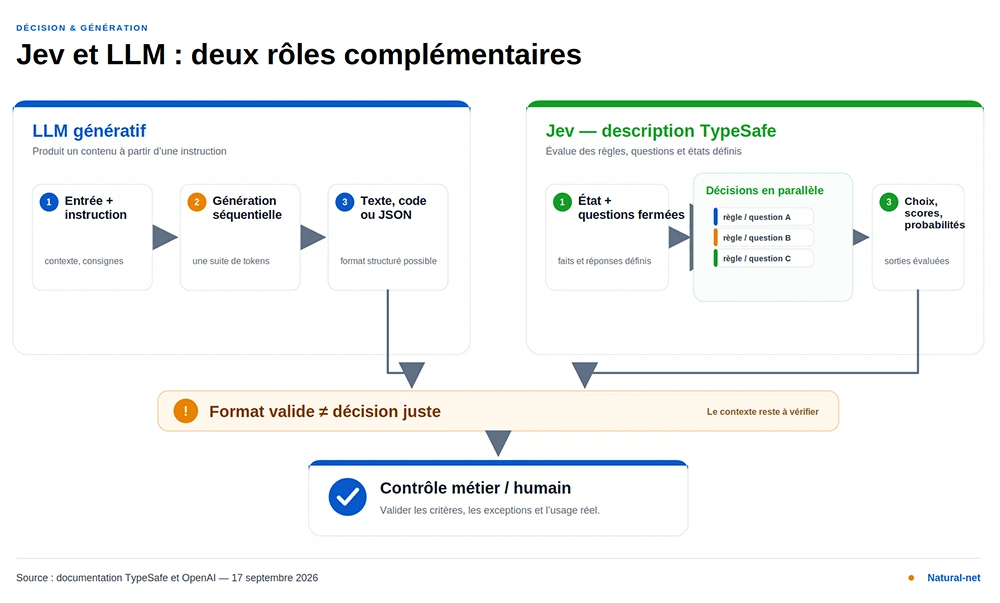
Un token est une unité de traitement qui ne correspond pas nécessairement à un mot complet. Un LLM autorégressif produit sa sortie progressivement : chaque nouveau token dépend de ce qui précède. Cette méthode permet de construire une phrase, un programme ou un document entier.
TypeSafe décrit un autre fonctionnement pour Jev : les probabilités des sorties seraient produites en parallèle, sans générer successivement une chaîne de texte libre. L’éditeur présente une nouvelle architecture, un mécanisme d’échantillonnage parallèle et un entraînement spécifique comme les éléments de cette approche.
Cette description explique la logique du produit, mais ne remplace pas un rapport technique reproductible sur son fonctionnement interne. Les détails publics disponibles ne permettent pas de reconstituer entièrement le modèle ni son entraînement.
Autre distinction utile : plusieurs questions évaluées en parallèle ne constituent pas automatiquement un raisonnement en plusieurs étapes. Si la réponse à une seconde question dépend du résultat de la première, le programme doit organiser cette dépendance.
Pourquoi Jev peut renvoyer du JSON sans générer de texte libre
Dire que Jev « ne génère pas de texte » ne signifie pas que sa réponse réseau ne contient aucun caractère. Une API doit transmettre ses résultats, par exemple dans un objet JSON, un format courant d’échange de données. Les noms des champs et les libellés des catégories restent alors visibles.
La distinction porte sur ce que le modèle est chargé de produire. Jev choisit des valeurs dans un cadre défini ; il n’est pas utilisé pour composer librement une explication. Le format de transport peut être textuel sans que la tâche soit une génération ouverte de langage.
Probabilités, confiance et calibration : que signifient les réponses de Jev ?
Une probabilité décrit une option ; la confiance résume une distribution
La documentation TypeSafe distingue la distribution des probabilités du champ confidence. Pour Choice et Score, ce dernier est une statistique calculée à partir de la forme de la distribution. Une distribution concentrée sur une option traduit une situation différente d’une distribution répartie entre plusieurs possibilités.
La confiance n’est donc pas simplement un autre nom pour la probabilité de l’option sélectionnée. Il ne faut pas non plus interpréter automatiquement une valeur de confiance comme une probabilité démontrée que la décision est correcte. La documentation propose cet indicateur pour faciliter le choix d’un comportement dans le code.
Cette nuance est utile lorsqu’une application doit choisir entre utiliser le résultat, demander davantage d’information ou transmettre le cas à une personne. Un indicateur numérique peut aider à organiser ce choix ; il ne remplace pas la validation de la méthode.
La calibration se vérifie sur un ensemble de prédictions
La calibration exprime la correspondance entre les probabilités annoncées et les fréquences de réussite observées. Dans un exemple théorique, parmi des prédictions auxquelles un modèle attribue une probabilité de 90 %, environ neuf sur dix devraient être correctes si le modèle est bien calibré sur ces cas.
Cette propriété concerne un ensemble de prédictions, pas une garantie donnée pour chaque réponse. Un modèle peut aussi être bien calibré sur un jeu d’évaluation et moins bien l’être sur des textes très différents, une autre langue ou des situations rares.
TypeSafe met en avant la calibration comme objectif central de Jev. L’éditeur recommande cependant de définir les seuils selon le contexte et de les tester sur ses propres données. Il n’existe pas un seuil universel qui transformerait toute décision en action sûre.
RLCD : un entraînement orienté vers les décisions calibrées
RLCD signifie Reinforcement Learning for Calibrated Decisions, soit un apprentissage par renforcement orienté vers des décisions calibrées. TypeSafe oppose cet objectif à celui du RLHF (Reinforcement Learning from Human Feedback), qui exploite des retours humains, ou du RLVR (Reinforcement Learning with Verifiable Rewards), qui s’appuie sur des récompenses vérifiables.
Le point à retenir est l’objectif annoncé : apprendre à fournir une décision accompagnée d’une incertitude exploitable, plutôt qu’à privilégier une formulation convaincante. RLCD désigne la méthode d’entraînement présentée par TypeSafe, pas à lui seul toute l’architecture du modèle.
Les sources publiques examinées ne détaillent pas suffisamment cette méthode pour en évaluer indépendamment tous les avantages. La calibration annoncée doit donc être considérée comme une propriété à mesurer, et non comme une immunité aux erreurs.
Jev, ChatGPT, Claude et les classificateurs : quelles différences ?
Jev ne remplace pas les usages de génération
Un LLM peut rédiger un texte, produire du code, expliquer un concept ou construire une réponse à partir de plusieurs informations. Jev n’offre pas ces sorties libres. Le comparer uniquement à ChatGPT ou à Claude en demandant lequel est « le meilleur » masque donc la différence de tâche.
La comparaison devient pertinente sur une question plus précise : pour choisir parmi des options ou évaluer une série de critères, quelle solution donne des résultats satisfaisants avec le meilleur compromis entre qualité, coût et délai ?
Un modèle génératif peut également produire du JSON selon un schéma imposé. OpenAI documente cette possibilité avec les Structured Outputs. Jev n’invente donc pas la sortie structurée. TypeSafe revendique une spécialisation de l’interface, de l’exécution et de l’entraînement autour de ce besoin.
| Dimension | Jev | LLM génératif | Règle ou classificateur spécialisé |
|---|---|---|---|
| Résultat principal | Décisions typées et probabilités | Texte, code ou sortie structurée | Résultat prévu pour une tâche ciblée |
| Rédaction libre | Non | Oui | Généralement non |
| Questions décrites en langage naturel | Oui, dans le cadre documenté | Oui | Selon la solution |
| Choix parmi des options | Fonction centrale | Possible avec encadrement | Souvent adapté à un domaine précis |
| Gestion de l’incertitude | Probabilités et confiance selon le type | Dépend du modèle et de l’intégration | Dépend de la méthode |
| Exactitude garantie | Non | Non | Une règle est exacte seulement dans le cadre correctement défini |
Ce qui existe déjà et ce qui reste intéressant dans Jev
La classification, le scoring et les sorties contraintes existaient avant Jev. Des modèles spécialisés peuvent déjà répondre efficacement à des tâches bien délimitées. Une simple règle reste souvent préférable lorsque le résultat dépend d’une condition explicite et stable.
Jev se distingue dans son positionnement par la volonté de proposer une interface commune pour de nombreuses décisions décrites par des instructions, avec des probabilités et plusieurs types de questions. Le développeur n’est pas invité à créer un modèle différent pour chaque catégorie de problème.
L’ingénieur Sean Goedecke souligne néanmoins qu’une partie des gains pourrait être obtenue avec des techniques existantes, comme le préremplissage de réponse et le décodage contraint de très courtes sorties. Son analyse pose une question importante : quelle part de la valeur vient du modèle lui-même, de son entraînement ou de la manière d’exécuter les prédictions ?
Cette objection ne démontre pas que Jev serait dépourvu d’intérêt. Elle invite à comparer des implémentations correctement optimisées. Une interface bien conçue et un service spécialisé peuvent avoir une valeur pratique, même lorsque certains principes techniques ne sont pas entièrement nouveaux.
Jev répond-il vraiment en 100 ms et peut-il battre les LLM ?
Une plage annoncée de 70 à 500 millisecondes
TypeSafe publie des temps de réponse de bout en bout de 70 à 500 millisecondes. Le chiffre de 100 ms, souvent associé à Jev depuis son lancement, doit être compris à la lumière de cette plage et de ses conditions de mesure.
Le billet de présentation indique que les évaluations sont généralement exécutées depuis des ordinateurs portables sur la côte Ouest américaine, où le service est alors situé. Ces mesures ne constituent ni un délai contractuel universel ni une mesure effectuée depuis tous les pays.
La latence réelle dépend notamment de la longueur de l’entrée, du réseau, de la charge et des étapes nécessaires au traitement. Il faut aussi distinguer le temps d’une réponse complète du temps d’apparition d’un premier token chez un modèle génératif. Comparer des indicateurs différents peut produire un avantage spectaculaire mais peu utile pour comprendre une application réelle.
Les ratios de vitesse et de coût proviennent des évaluations TypeSafe
L’éditeur affiche des gains de 193,6 fois en vitesse et de 444,6 fois en coût sur ses évaluations de workflows. Il précise que ces résultats pourraient se situer dans la partie haute des gains obtenus dans les usages réels.
Les quatre workflows publiés portent sur les incidents de sécurité, l’observation des traces d’agents, le traitement de factures et le service client. Ils ont été construits par l’équipe TypeSafe. Les références utilisées reposent sur les réponses de GPT-6 Astra et Claude Fable 5.1, plutôt que sur une vérité terrain indépendante constituée pour chaque cas.
Les LLM comparés utilisent également un adaptateur pour produire des décisions structurées avec des probabilités. TypeSafe reconnaît que cette configuration peut les rendre plus lents et plus coûteux que des réponses structurées sans ces informations supplémentaires.
Ces précisions ne rendent pas les résultats inutiles. Elles définissent leur portée : ce sont des comparaisons publiées par le fournisseur, sur un protocole déterminé. Elles ne démontrent pas que Jev serait supérieur à tout LLM, sur toute tâche et avec toute configuration.
| Chiffre publié | Ce qu’il décrit | Ce qu’il ne faut pas en déduire |
|---|---|---|
| 70 à 500 ms | Plage de latence annoncée par TypeSafe | Un maximum garanti dans tous les contextes |
| 193,6 fois plus rapide | Résultat sur les workflows de l’éditeur | Une vitesse universellement supérieure |
| 444,6 fois moins cher | Comparaison de coûts selon ce protocole | Une réduction identique de tout budget d’IA |
| Absence d’erreur de type revendiquée | Respect du schéma et des options autorisées | Absence d’erreur de compréhension ou de choix |
« Sans hallucination » ne veut pas dire « toujours juste »
TypeSafe met en avant l’impossibilité de produire une valeur hors du schéma prévu. Si les choix autorisés sont « rouge », « bleu » et « vert », le modèle ne devrait pas répondre par une quatrième option inventée.
Il peut cependant choisir « rouge » alors que la réponse attendue est « bleu ». La sortie respecte le format, mais son contenu est faux. C’est pourquoi l’expression « zéro hallucination » ne doit pas être interprétée comme une absence de toute erreur.
La distinction vaut également pour les sorties structurées de LLM : la documentation OpenAI rappelle qu’elles peuvent contenir des erreurs malgré le respect du schéma. Réduire les erreurs de format est un avantage d’intégration ; garantir le sens d’une décision est un problème différent.
Quel est le prix de Jev ?
Au 17 septembre 2026, TypeSafe affiche un tarif de 0,042 dollar par million de tokens d’entrée, avec des sorties annoncées comme gratuites. Il s’agit du tarif public consulté, à vérifier au moment de l’accès ou de la souscription.
Le coût dépend donc notamment du volume de contexte transmis au service. Une décision portant sur un court message et une évaluation portant sur un long document ne consomment pas la même quantité de tokens d’entrée.
Il faut également distinguer le prix d’un appel du coût d’un traitement complet. Un processus peut appeler le modèle plusieurs fois, demander un complément à un LLM ou nécessiter une correction humaine. L’indicateur pertinent reste le coût d’un résultat utile à qualité comparable.
Le faible tarif affiché ne signifie pas que Jev est un service gratuit. La gratuité annoncée des sorties concerne une composante de la facturation. Elle ne permet pas non plus d’affirmer que le tarif restera identique dans le temps.
À quoi peut servir Jev ?
Classer et évaluer des contenus
La classification est l’usage le plus direct : attribuer un thème à un texte, identifier un type de document ou sélectionner une catégorie parmi celles proposées. Le scoring ajoute une évaluation sur une échelle définie, par exemple le degré de correspondance entre un contenu et une consigne.
Ces possibilités ne signifient pas que Jev sait automatiquement définir une bonne taxonomie. Une liste de catégories ambiguë ou incomplète reste un problème de conception. Le modèle peut aider à appliquer un cadre, mais ce cadre doit être pertinent.
Orienter une requête vers le bon traitement
Un programme peut utiliser une décision structurée pour déterminer quelle étape vient ensuite. Une requête simple pourrait être traitée par une règle, une demande de rédaction par un LLM, et une situation ambiguë par une demande de clarification.
Le routage de modèles est un exemple de cette logique : sélectionner une ressource adaptée plutôt que solliciter systématiquement le modèle le plus coûteux. Cela reste une architecture à évaluer, pas une économie automatiquement obtenue en ajoutant Jev.
Évaluer des documents dans une chaîne de recherche
Une autre piste consiste à apprécier la pertinence d’éléments déjà récupérés : ce passage répond-il à la question ? Ce document correspond-il au sujet ? Parmi plusieurs candidats, lequel mérite une vérification supplémentaire ?
Jev ne doit pas être confondu avec le moteur qui collecte ces informations. Une architecture RAG, pour Retrieval-Augmented Generation ou génération augmentée par récupération d’informations, associe recherche de sources et génération à partir du contexte trouvé. Un composant de décision peut éventuellement s’insérer entre ces étapes, sans remplacer la recherche ni la génération. Notre article sur le fonctionnement du RAG en intelligence artificielle détaille cette organisation.
Contrôler certaines étapes d’un agent IA
TypeSafe présente aussi des usages de vérification et de garde-fous : évaluer une sortie, détecter un comportement problématique ou signaler qu’une étape nécessite une revue. Un agent peut en effet accomplir de nombreuses opérations qui ne demandent pas toutes une longue réponse rédigée.
Il ne faut toutefois pas faire d’un modèle le seul dispositif de sécurité d’un autre modèle. Les droits d’accès, les listes d’actions autorisées et les validations déterministes restent nécessaires. Une confirmation humaine peut être indispensable avant une action importante, même si le modèle indique une confiance élevée.
Les usages décrits ici correspondent à des fonctions documentées ou à des architectures possibles. Ils ne constituent pas des intégrations Jev testées par Natural-net.
Pourquoi les démonstrations Doom et Wikiracing sont-elles intéressantes ?
Doom : des décisions rapides à partir d’un état de jeu
TypeSafe a présenté une démonstration dans laquelle Jev participe au pilotage du jeu Doom. Son intérêt est d’illustrer des décisions suffisamment rapides pour s’intégrer à une boucle interactive, plutôt que de montrer une nouvelle interface de conversation.
Une précision est essentielle : la démonstration utilise une représentation structurée et textuelle de l’état du jeu, pas une analyse des images de l’écran. Elle ne démontre donc pas une capacité de vision du modèle.
L’éditeur reconnaît également qu’un bot classique spécialisé pourrait mieux jouer. Le but de la démonstration est de montrer la possibilité d’interpréter un état et des instructions dans une boucle rapide, pas d’établir un record de performance vidéoludique.
Wikiracing : choisir un lien parmi des possibilités réelles
Le principe du Wikiracing consiste à partir d’une page Wikipédia et à atteindre une page cible en suivant uniquement les liens rencontrés. À chaque étape, le système doit sélectionner une possibilité dans un ensemble parfois important.
Ce cas illustre bien l’intérêt des choix contraints : sélectionner un lien disponible n’est pas la même tâche que rédiger le nom d’une page plausible. Le modèle est évalué sur la décision à prendre parmi des options concrètes.
TypeSafe précise que Jev prend en charge jusqu’à 255 options pour un choix. Dans sa démonstration, les ensembles plus larges sont traités en deux étapes, avec une évaluation préalable puis un choix explicite. L’éditeur indique également que les réglages de raisonnement des modèles comparés influencent fortement les résultats.
Ces démonstrations donnent des idées d’usage et rendent le concept visible. Elles ne suffisent pas à établir la robustesse du modèle dans toutes les situations, ni une supériorité générale sur les systèmes concurrents.
Comment accéder à Jev et utiliser l’API TypeSafe ?
Commencer par le Playground
TypeSafe documente un Playground, c’est-à-dire une interface de test accessible dans le navigateur. Le parcours consiste à fournir un état, à ajouter une question puis à examiner la réponse. Plusieurs questions de types différents peuvent être regroupées dans une même requête.
L’accès était annoncé en phase anticipée au lancement, avec une liste d’attente. La présence du Playground dans la documentation ne garantit donc pas l’accès immédiat de tout nouvel utilisateur. Le site officiel TypeSafe reste le point de départ pour vérifier la disponibilité.
Une API, une clé et un modèle à sélectionner
Une API, ou interface de programmation, permet à un logiciel d’envoyer des données à un service et de récupérer sa réponse. Celle de TypeSafe utilise une requête POST vers https://api.typesafe.ai/v1/systemone, avec une clé d’authentification. L’identifiant jev-latest apparaît dans le guide de démarrage.
Voici un exemple pédagogique de corps de requête, adapté du format officiel. Il illustre la question Noul, sans constituer un appel exécuté ni un résultat mesuré :
{
  "model": "jev-latest",
  "state": "Ce texte explique comment installer un logiciel en trois étapes et vérifier le résultat.",
  "questions": {
    "est_un_tutoriel": {
      "type": "noul",
      "instructions": "Le texte décrit-il une procédure à suivre ?"
    }
  }
}
La réponse attendue contient une valeur Noul : une probabilité de réponse positive. Si l’application doit ensuite afficher une étiquette « tutoriel », elle définit séparément les conditions de cette transformation. Le modèle fournit une estimation ; le programme fixe la règle d’usage.
La clé API doit rester côté serveur ou dans un environnement prévu pour protéger les secrets. Elle ne doit pas être publiée dans le code d’une page accessible aux visiteurs.
Les SDK Python et JavaScript
TypeSafe publie des SDK, ou bibliothèques clientes, pour faciliter l’intégration. Le guide Python utilise le paquet typesafe-sdk ; le SDK JavaScript/TypeScript est publié sous le nom @typesafe-ai/sdk. Ces outils simplifient la construction des questions et la lecture des résultats.
Pour un premier essai, le plus utile est de choisir une tâche claire et un petit ensemble de cas dont la réponse attendue est connue. Ajoutez volontairement des exemples ambigus, des entrées incomplètes et une option de sortie adaptée au doute. Cela révèle davantage sur le comportement du système qu’une seule démonstration réussie.
Pour une comparaison sérieuse, conservez les cas de test, la version du modèle, les consignes et les critères. Une référence nommée « latest » pouvant évoluer, les résultats doivent rester associés au contexte dans lequel ils ont été observés.
Quelles sont les limites actuelles de Jev ?
L’absence d’explication libre réduit certains usages
Jev retourne des décisions, pas une argumentation détaillée. C’est cohérent avec son objectif, mais cela limite son usage lorsqu’un lecteur attend une justification rédigée, une synthèse ou un raisonnement développé.
Un autre modèle peut être chargé d’expliquer un résultat dans une architecture composée. Il faut alors éviter de confondre cette explication produite après coup avec une description fidèle du fonctionnement interne de Jev. Une formulation convaincante n’établit pas, à elle seule, pourquoi le premier modèle a choisi une option.
Les critères et les données restent déterminants
Une question mal posée, des catégories qui se recouvrent ou un contexte insuffisant peuvent produire des réponses peu utiles. La rapidité ne corrige pas ces défauts. Le modèle doit également être évalué sur la langue, les documents et les situations qui seront effectivement rencontrés.
À la date de vérification de ce guide, les sources examinées ne fournissent pas de mesure indépendante complète permettant de garantir les performances de Jev en français dans tous les domaines. L’exemple francophone présenté plus haut illustre la structure d’une requête, pas une validation de sa qualité linguistique.
Jev est-il open source ?
Les SDK et certains outils TypeSafe sont disponibles publiquement, notamment sous licence MIT. En revanche, les sources publiques examinées ne donnent pas accès aux poids de Jev, à son code d’entraînement ou à une procédure d’auto-hébergement.
Des bibliothèques clientes ouvertes ne rendent pas le modèle lui-même open source. Il ne faut donc pas présenter Jev comme un modèle que chacun peut télécharger et exécuter localement sur cette seule base.
Quelles précautions prendre avec les données ?
La politique de confidentialité publique de TypeSafe indique un hébergement des services aux États-Unis et un transfert des données provenant notamment de l’Espace économique européen vers les États-Unis pour stockage et traitement. Elle indique aussi que les entrées ne servent pas à entraîner ou affiner les modèles.
Ces informations doivent être lues avec les conditions contractuelles applicables. Avant de transmettre des données personnelles ou confidentielles, il faut notamment vérifier la finalité du traitement, la conservation, les prestataires impliqués, les mécanismes de transfert et les garanties de sécurité. Une sortie courte ou typée ne supprime pas le traitement des informations envoyées en entrée.
Pour découvrir l’outil, des données fictives ou réellement anonymisées permettent de commencer sans exposer inutilement des informations sensibles. L’usage de Jev ne constitue pas, en soi, une preuve de conformité au RGPD.
Jev annonce-t-il une nouvelle manière de construire avec l’IA ?
L’intérêt d’une IA moins visible, mais plus présente dans le logiciel
La nouveauté la plus intéressante n’est peut-être pas l’idée d’une IA qui « parle moins ». Elle réside dans la possibilité de choisir une interface adaptée à chaque tâche. Un texte est pertinent pour expliquer. Une probabilité peut être plus pertinente pour gérer une incertitude. Une option fermée peut être plus pratique pour orienter une étape.
Cette lecture conduit à une IA composable : des composants aux rôles distincts sont assemblés par le logiciel. La génération, la recherche d’informations, l’évaluation et l’exécution ne sont plus nécessairement confiées à un seul appel qui devrait tout résoudre.
Jev s’inscrit dans cette direction sans en garantir à lui seul la réussite. La qualité d’un système dépend aussi des données, des règles, des interfaces et des contrôles qui relient ses composants.
Les preuves qui permettront de juger la suite
Pour apprécier durablement l’intérêt de Jev, plusieurs éléments seront plus importants que les effets d’annonce : des comparaisons indépendantes, des mesures de calibration sur des données variées, des performances observées sous charge et une documentation technique plus détaillée.
Il faudra également observer la facilité d’intégration, la stabilité des versions et la capacité du modèle à maintenir un bon compromis entre qualité, coût et délai face à des alternatives optimisées. La spécialisation doit apporter un avantage mesurable, pas seulement un nouveau vocabulaire.
Notre lecture chez Natural-net est donc celle d’un déplacement de perspective : l’IA ne se limite pas à produire du contenu ; elle peut aussi fournir des décisions élémentaires à un programme. Comprendre cette distinction aide à analyser les nouveaux outils sans confondre démonstration, capacité réelle et promesse commerciale.
Jev ne rend pas les LLM obsolètes. Il remet au premier plan une question plus féconde : pour chaque étape, faut-il générer une réponse, récupérer une information, appliquer une règle ou estimer un choix ? C’est dans la qualité de cet assemblage que se jouera une partie de l’évolution des applications d’IA.
Natural-net décrypte ces évolutions dans ses travaux sur le web et l’intelligence artificielle. Pour prolonger la réflexion sur leurs implications dans vos projets numériques, vous pouvez échanger avec notre équipe.
Foire aux questions sur Jev et TypeSafe
Qu’est-ce que Jev de TypeSafe ?
Jev est un modèle d’IA conçu par TypeSafe pour produire des décisions structurées : choix parmi des options, scores et probabilités. Il reçoit un contexte et des questions définies par l’application. Il ne génère pas de texte libre comme un assistant conversationnel.
Que signifie « System One Model » ?
TypeSafe utilise cette expression pour désigner des modèles orientés vers des décisions rapides et directement exploitables par un logiciel. Le nom s’inspire de la distinction entre pensée rapide et pensée délibérée popularisée par Daniel Kahneman. Il ne constitue pas une preuve que le modèle reproduit une architecture cognitive humaine.
Qui a créé Jev ?
Jev est développé par TypeSafe AI, un laboratoire fondé en 2024 par Diogo Almeida, Erik Gafni et Sasha Sheng. Diogo Almeida est un ancien chercheur d’OpenAI ayant contribué aux travaux sur le suivi d’instructions. L’annonce publique de Jev date du 15 septembre 2026.
Pourquoi Jev ne génère-t-il pas de texte ?
TypeSafe a choisi de concentrer Jev sur des valeurs définies à l’avance plutôt que sur la rédaction de réponses libres. L’objectif annoncé est de rendre certaines décisions plus rapides et plus faciles à intégrer dans des programmes. Ce choix empêche Jev de remplacer un LLM pour écrire, coder ou expliquer librement.
Jev peut-il renvoyer du JSON ?
Oui, l’API transmet des réponses structurées en JSON. Cela ne signifie pas que Jev génère librement un texte : les champs et les valeurs suivent le contrat de sortie prévu. Il faut distinguer le format d’échange de données de la tâche réalisée par le modèle.
Quelle est la différence entre Choice, Score et Noul ?
Choice sélectionne une option et fournit des probabilités ainsi qu’un indicateur de confiance. Score évalue un contexte selon des niveaux ordonnés définis par l’application. Noul renvoie une probabilité de réponse positive à une question oui/non, sans champ de confiance distinct.
Le score de confiance indique-t-il que la réponse est vraie ?
Non. Pour Choice et Score, TypeSafe calcule la confiance à partir de la distribution des probabilités. Cet indicateur aide à adapter le comportement du programme, mais ne garantit pas la justesse d’une décision. Les seuils et la calibration doivent être évalués sur des cas représentatifs.
Jev répond-il toujours en 100 millisecondes ?
Non, ce délai ne constitue pas une garantie universelle. TypeSafe publie une plage de 70 à 500 millisecondes dans son contexte d’évaluation, principalement sur la côte Ouest américaine. Le réseau, la longueur des entrées, la charge et l’organisation des appels influencent la latence réelle.
Jev est-il meilleur que ChatGPT ou Claude ?
Il n’existe pas de supériorité générale établie. Jev vise les décisions structurées, tandis que les LLM génératifs couvrent notamment la rédaction et la production de code. Les gains annoncés par TypeSafe proviennent de ses propres évaluations et ne se transposent pas automatiquement à toutes les tâches.
Jev est-il vraiment sans hallucination ?
TypeSafe revendique l’absence de valeurs hors du schéma ou des options autorisées. Jev peut néanmoins sélectionner une option incorrecte. La conformité du format réduit un type d’erreur, mais ne garantit ni une bonne compréhension du contexte ni une décision juste.
Quel est le prix de Jev et est-il gratuit ?
Au 17 septembre 2026, TypeSafe affiche 0,042 dollar par million de tokens d’entrée et des sorties gratuites. Le service n’est donc pas entièrement gratuit sur cette base. Les tarifs et conditions d’accès doivent être vérifiés auprès de l’éditeur au moment de l’utilisation.
Comment essayer Jev ?
TypeSafe documente un Playground dans le navigateur et une API accessible avec une clé. L’accès était annoncé en phase anticipée au lancement. Les SDK Python et JavaScript facilitent l’intégration, mais la disponibilité du service pour un nouveau compte doit être confirmée auprès de TypeSafe.
Peut-on utiliser Jev en français ?
Une requête peut être construite avec du texte et des consignes en français. Les sources examinées ne fournissent toutefois pas de benchmark indépendant complet établissant la qualité de Jev en français dans tous les domaines. Il faut tester les réponses sur des exemples représentatifs avant de conclure.
Jev est-il open source ?
Les SDK et certains outils TypeSafe sont publics, mais les sources examinées ne publient ni les poids de Jev ni une procédure d’auto-hébergement. Il ne faut donc pas confondre l’ouverture des bibliothèques clientes avec celle du modèle lui-même.
Jev est-il un agent IA autonome ?
Non, Jev est un modèle de décisions structurées qui peut être intégré dans un agent ou une autre application. Le programme qui l’entoure organise les étapes, les outils, les permissions et les actions. Jev ne fournit pas à lui seul l’ensemble de cette orchestration.
Sources et documentation
Sources consultées le 17 septembre 2026. Les caractéristiques et chiffres attribués à TypeSafe proviennent de sa documentation, de son annonce et de ses évaluations publiques. Ce guide est une analyse documentaire ; Natural-net n’a pas réalisé de benchmark de Jev. Les exemples et schémas de principe ne constituent pas des résultats expérimentaux.
- TypeSafe — Introducing System One Models & Jev : annonce datée du 15 septembre 2026, concept, RLCD, origine des noms, chiffres et limites des démonstrations.
- TypeSafe, communiqué diffusé par Business Wire — TypeSafe AI Emerges From Stealth With $40M in Funding With New Model for Composable AI, 15 septembre 2026 : équipe fondatrice, création de TypeSafe et accès anticipé.
- TypeSafe — Primitives (Questions) : Choice, Score et Noul.
- TypeSafe — Confidence : distinction entre probabilités et confiance, incertitude et choix des seuils.
- TypeSafe — AI primer : principes présentés par l’éditeur, décisions calibrées et limites d’interprétation.
- TypeSafe — Quick start : Playground, API et exemple de prise en main.
- TypeSafe — API reference : format des requêtes et des réponses.
- TypeSafe — Workflow evals : évaluations fournisseur et méthode de comparaison.
- TypeSafe — organisation GitHub officielle : SDK et outils publics.
- TypeSafe — Privacy policy : hébergement, entrées, transferts et conservation.
- OpenAI — Structured model outputs : sorties contraintes par un schéma JSON et erreurs possibles malgré leur validité.
- Sean Goedecke — Jev means structured output is interesting again, 16 septembre 2026 : analyse technique indépendante sur l’interface, le décodage contraint et les limites des comparaisons ; ne constitue pas un benchmark indépendant complet de Jev.